
卓驭 ZYT-World:如果智驾有“时光机”它会长什么样
扫一扫
关注微信公众号
卓驭 ZYT-World:如果智驾有“时光机”它会长什么样
卓驭的ZYT-World发布了,作为首个能想象也能重建的可控世界模型,我们理解下来,ZYT-World其实就干一件事:给物理AI开一间可以无限补考的“平行世界驾校”。
现实世界最残酷的地方,是它不给第二次机会。鬼探头、恶意加塞、盲区里突然窜出的电瓶车——这些最危险的场景,真实路上等一年未必碰上一次;碰上一次,可能就结束了。高频驾驶可以靠路采慢慢攒,但安全的上限,恰恰由这些“等不到、试不起”的低频高风险事件决定。
所以,聪明的办法不是让真车去赌,而是给AI造一个可控、可重复、可归因的平行世界,让极端场景在里面被无限预演。ZYT-World,就是卓驭造出的这台“平行世界引擎”。
它不是一段好看的视频,也不是一个演示品。它已经落在卓驭三条技术线上:往下,给量产模型做闭环仿真评测和长尾数据合成;往上,给原生多模态物理AI模型当强化学习训练场;往外,用相机控制能力把已有数据拓展到重卡、物流车等平台。
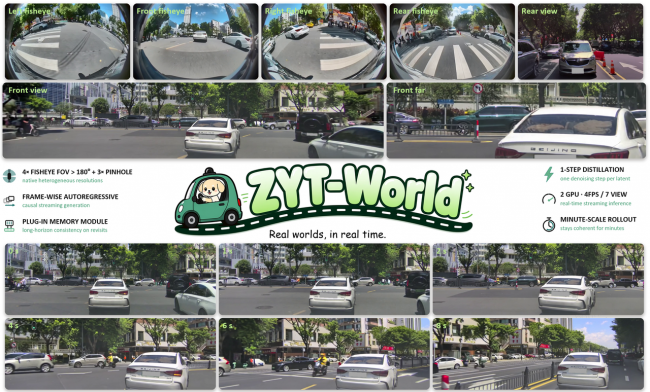
一、先说三个词:世界模型、强化学习、闭环
世界模型,就是“脑补下一秒”。
人开车时,看到前车刹车灯亮,不用等它真停下,脑子里已经预判到接下来会发生什么。AI的世界模型,就是从海量真实驾驶视频里学会车怎么动、光怎么变、路口长什么样;给它一个开头和一串指令,它就能实时推演出多路摄像头接下来会看到的画面。
强化学习,就是“试错学习”。
不给标准答案,只给奖惩。做对了加分,撞了扣分,让AI在环境里反复试,自己试出一套高分策略。AlphaGo就是这么自己跟自己下了几百万盘练出来的。它最吃的资源是“环境”——下棋的环境是规则,不要钱;开车的环境是整个世界,真车撞一次代价太大。
闭环,就是“把方向盘插上电”。
传统自动驾驶测试是开环:看录像、握一个不插电的方向盘,AI说“我会打左”,却永远验证不了打了左之后会怎样。闭环世界里,AI打左,世界真往左,新画面再喂回AI。它既是考场,也是训练场。
闭环逼着世界模型同时做到四件事:真实、可控、反应快、记得住。ZYT-World要做的,就是同时过关。
二、为什么是“脑补”,而不是“拍3D照”
NeRF、3D Gaussian Splatting这类重建技术,像把真实道路扫成3D照片。几何很准,但只能复刻,不能加戏:扫描那天有5辆车,就只有5辆车;想加一个横穿行人,做不了;每条路还得重扫。
世界模型不扫描,而是学习世界怎么运转。它的长处,正是重建的死穴——能想象。没发生过的事故可以生成,红绿灯可以改,旁车可以加塞。这种“反事实”场景,恰恰是评测和训练最缺的长尾。
但纯脑补容易“编过头”:第二次路过同一路口,路牌可能换了颜色。
所以ZYT-World的思路是:生成负责想象,记忆负责认路。
三、它厉害在哪?四个字:真、控、记、快
真:多目异构,一起脑补。
量产车的摄像头不止一种:有鱼眼,也有针孔,画幅五花八门。很多方案先把它们“翻译”成一种标准镜头再生成,结果是像,但不像你车上那组眼睛。ZYT-World原生同时生成所有视角,鱼眼是鱼眼、针孔是针孔,并严格对齐同一时刻。
控:三层可控,干预可测。
控自车:同一起点,掉头和刹停是两个世界。
控他车:前车急刹、旁车加塞、电瓶车从盲区窜出。
控道路环境:直路改岔路、绿灯提前变红。
一次只动一个变量,AI司机哪里不行,一测就知道。相机也能换:同一段乘用车数据,换套相机参数重新生成,就成了重卡、物流车视角的数据。
记:记忆回溯,老路重逢。
当车辆沿另一条轨迹重新驶入去过的路段,记忆模块会翻出“历史观测”,把路牌、路边停着的车这些不会走路的东西找回来,而不是随机再编一个。同一场景下两条独立轨迹因此完全对齐。
快:两张卡,实时长跑。
40步压到1步,再配整套推理加速,生成器比40步老师快107.7倍。有界KV-cache让显存不随时间增长;训练只见过8秒片段,却能连续跑1分钟以上,车道、建筑、光照依然稳。
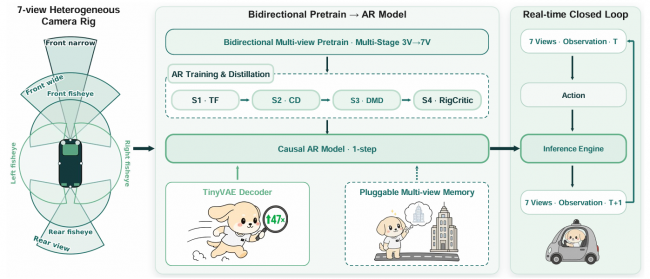
四、它是怎么做出来的?
简单说,底座是“逐帧接龙”:每步只生成一个时刻的多视角画面,写进KV-cache再推下一步。
40步压成1步,靠四阶段“师徒传功”:因果化、一致性蒸馏、自回滚DMD、RigCritic。结果就是:学生模型1步画完,画质保持老师的90%以上。
记忆模块是零初始化插件:刚接上对基座几乎零影响,不接时整层跳过。训练数据用端到端模型在真实场景上生成替代轨迹并重建渲染,已攒近百万对。
推理栈则抠每一毫秒:TinyVAE、低比特矩阵乘、自研推理框架、硬件感知优化,单次推理进一步加速1.6倍。两张GPU协同,叠加1步去噪,最终达到107.7倍加速,保障实时推理。
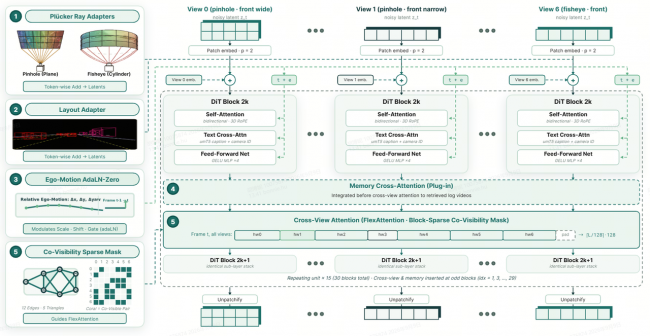
五、写在最后
我们理解,ZYT-World带来的不是一段路测场景,也不是一段视频,而是一个可以被驶入、被改写、且认得路的平行世界。
当一个世界模型真正复刻了物理逻辑,模型在平行世界里习得的知识和分寸感,就能在现实中生效。不只是对一种车,而是对所有遵循同一套物理逻辑的移动载具。
ZYT-World不是宣称仿真已经替代路测,而是给出一条路径:
把“最贵”、也“最危险”的那一课,先在平行世界里上完。
现实不给第二次机会,平行世界可以。
多目全知,逐帧实时,万物可控,生成想象,记忆认路。
 头条资讯


 推荐资讯


